Modelo: Logistic Regression
Este proyecto usa un dataset real de calidad de vino tinto.
La idea es clasificar si un vino puede considerarse de buena calidad usando pocas variables químicas.
Este proyecto puede conectar con:
Química: acidez, alcohol, sulfatos, densidad.
Matemáticas: clasificación binaria, proporciones, evaluación de modelos.
Ciencias: relación entre propiedades medibles y calidad.
Pregunta del proyecto
¿Podemos clasificar si un vino es de buena calidad usando algunas propiedades químicas?
Modelo que usarás
LogisticRegressionVariables sugeridas
Features X:
alcoholvolatile aciditysulphatesdensity
Target y:
good_quality
Donde:
1: vino de buena calidad0: vino de calidad regular
Paso 1: Importar librerías
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, ConfusionMatrixDisplay

print("Librerías cargadas correctamente.")
Librerías cargadas correctamente.
Paso 2: Cargar la data
Ejecuta la celda.
El dataset se cargará desde UCI Machine Learning Repository.
url = "https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv"

df = pd.read_csv(url, sep=";")

df.head()Paso 3: Explorar rápidamente la data
df.shape(1599, 12)df[["alcohol", "volatile acidity", "sulphates", "density", "quality"]].describe()Paso 4: Crear la variable objetivo
La columna original quality va de valores bajos a altos.
Para convertir esto en clasificación binaria, crearemos:
good_quality = 1 si quality >= 6
good_quality = 0 si quality < 6
Ejecuta la celda.
df["good_quality"] = (df["quality"] >= 6).astype(int)

df[["quality", "good_quality"]].head(10)Paso 5: Visualizar la variable objetivo
df["good_quality"].value_counts().plot(kind="bar")

plt.title("Distribución de calidad del vino")
plt.xlabel("0 = regular, 1 = buena calidad")
plt.ylabel("Cantidad")
plt.show()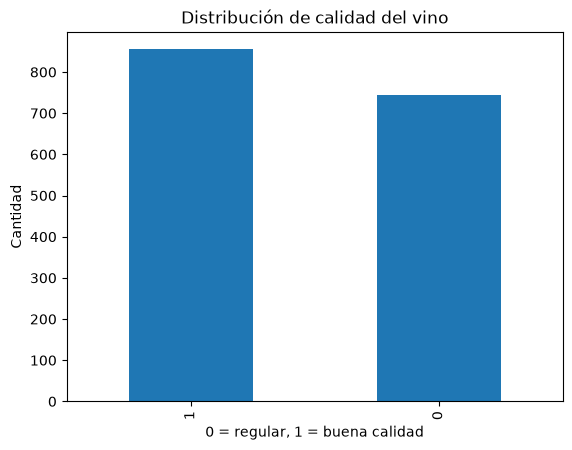
Paso 6: Visualizar alcohol vs calidad
Observa si el alcohol parece estar relacionado con la calidad.
plt.figure(figsize=(8,5))
plt.scatter(df["alcohol"], df["good_quality"], alpha=0.2)
plt.xlabel("Alcohol")
plt.ylabel("Buena calidad")
plt.title("Alcohol vs calidad")
plt.show()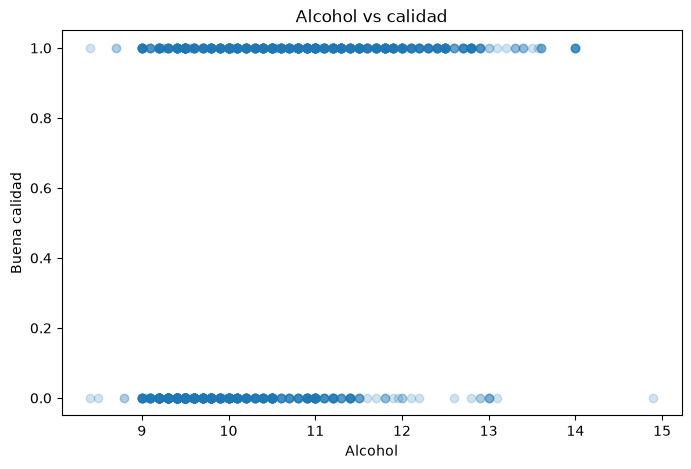
Paso 7: Definir features y target
Completa la celda.
Features sugeridas:
["alcohol", "volatile acidity", "sulphates", "density"]Target:
"good_quality"X = df[[___, ___, ___, ___]]
y = df[___]
X.head()---------------------------------------------------------------------------
KeyError Traceback (most recent call last)
Cell In[8], line 1
----> 1 X = df[[___, ___, ___, ___]]
2 y = df[___]
3
4 X.head()
File /opt/hostedtoolcache/Python/3.12.14/x64/lib/python3.12/site-packages/pandas/core/frame.py:4384, in DataFrame.__getitem__(self, key)
4380 indexer = [indexer]
4381 else:
4382 if is_iterator(key):
4383 key = list(key)
-> 4384 indexer = self.columns._get_indexer_strict(key, "columns")[1]
4385
4386 # take() does not accept boolean indexers
4387 if getattr(indexer, "dtype", None) == bool:
File /opt/hostedtoolcache/Python/3.12.14/x64/lib/python3.12/site-packages/pandas/core/indexes/base.py:6302, in Index._get_indexer_strict(self, key, axis_name)
6299 else:
6300 keyarr, indexer, new_indexer = self._reindex_non_unique(keyarr)
-> 6302 self._raise_if_missing(keyarr, indexer, axis_name)
6304 keyarr = self.take(indexer)
6305 if isinstance(key, Index):
6306 # GH 42790 - Preserve name from an Index
File /opt/hostedtoolcache/Python/3.12.14/x64/lib/python3.12/site-packages/pandas/core/indexes/base.py:6352, in Index._raise_if_missing(self, key, indexer, axis_name)
6350 if nmissing:
6351 if nmissing == len(indexer):
-> 6352 raise KeyError(f"None of [{key}] are in the [{axis_name}]")
6354 not_found = list(ensure_index(key)[missing_mask.nonzero()[0]].unique())
6355 raise KeyError(f"{not_found} not in index")
KeyError: "None of [Index([(1599, 12), (1599, 12), (1599, 12), (1599, 12)], dtype='object')] are in the [columns]"X_train, X_test, y_train, y_test = train_test_split(
___,
___,
test_size=___,
random_state=___,
stratify=___
)
print("Datos de entrenamiento:", X_train.shape)
print("Datos de prueba:", X_test.shape)Paso 9: Crear y entrenar el modelo
Completa usando LogisticRegression.
Pista:
modelo = LogisticRegression(max_iter=1000)
modelo.fit(X_train, y_train)
modelo = ___
modelo.___(x_train, Y_train)
print("Modelo entrenado correctamente.")Paso 10: Hacer predicciones
Debes completar la línea usando .predict().
y_pred = modelo.___(x_train)

resultados = pd.DataFrame({
    "Real": y_test.values,
    "Predicción": y_pred
})

resultados.head(10)
Paso 11: Evaluar accuracy
Encuentra y corrige el error
accuracy = Accuracy_score(y_test, y_pred)

print(f"Accuracy del modelo: {accuracy:.2f}")
Paso 12: Matriz de confusión
ConfusionMatrixDisplay.from_predictions(
    y_test,
    y_pred
)

plt.title("Matriz de confusión - Calidad del vino")
plt.show()
Paso 13: Probar un vino nuevo
Completa los valores del vino nuevo.
Debe tener las mismas columnas que X.
Ejemplo de columnas:
alcohol
volatile acidity
sulphates
density
vino_nuevo = pd.DataFrame({
    "alcohol": [___],
    "volatile acidity": [___],
    "sulphates": [___],
    "density": [___]
})

prediccion = modelo.predict(vino_nuevo)

print("Predicción:", prediccion[0])
print("0 = calidad regular, 1 = buena calidad")Conclusión
Escribe una conclusión breve:
¿Qué intentaba clasificar el modelo?
¿Qué features usaste?
¿Qué accuracy obtuvo?
¿El modelo fue capaz de identificar patrones químicos relacionados con la calidad?
Nota
Este proyecto usa pocas variables químicas.
Los resultados pueden mejorar si se agregan más features, pero aquí la meta es practicar clasificación binaria con Logistic Regression.