Construye tu primer modelo de clasificación usando el dataset Iris
En este proyecto vamos a trabajar con un dataset real muy usado en Machine Learning: Iris.
El objetivo es construir un modelo que pueda clasificar flores en una de tres especies usando medidas reales de sus sépalos y pétalos.
Este notebook está diseñado para docentes de High School. La idea es que puedan seguir instrucciones claras, ejecutar código, interpretar resultados y luego adaptar la experiencia a sus propias clases.
Objetivos del proyecto
Al finalizar este proyecto podrás:
Cargar un dataset real.
Explorar datos usando tablas y gráficas.
Identificar variables de entrada
Xy variable objetivoy.Dividir datos en entrenamiento y prueba.
Entrenar un modelo de clasificación.
Evaluar el modelo usando accuracy y matriz de confusión.
Modificar el modelo y comparar resultados.
Diseñar una idea propia para usar Machine Learning en el salón de clases.
Contexto del dataset Iris
El dataset Iris contiene medidas de flores de tres especies:
Setosa
Versicolor
Virginica
Para cada flor se midieron cuatro características:
Longitud del sépalo
Ancho del sépalo
Longitud del pétalo
Ancho del pétalo
La pregunta del proyecto es:
¿Puede un modelo de Machine Learning aprender a identificar la especie de una flor usando estas medidas?
Este dataset viene incluido en scikit-learn, por lo que no necesitamos descargar archivos externos.
Parte 1: Importar librerías
Primero importamos las herramientas que vamos a usar.
Ejecuta la siguiente celda.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, ConfusionMatrixDisplay, classification_report

print("Librerías importadas correctamente.")
Librerías importadas correctamente.
Parte 2: Cargar los datos reales
Ahora cargamos el dataset Iris desde scikit-learn.
Ejecuta la celda y observa qué contiene el objeto iris.
iris = load_iris()

iris.keys()
dict_keys(['data', 'target', 'frame', 'target_names', 'DESCR', 'feature_names', 'filename', 'data_module'])Preguntas para discutir
¿Qué crees que significa
data?¿Qué crees que significa
target?¿Qué crees que significa
feature_names?¿Qué crees que significa
target_names?
print("Nombres de las variables:")
print(iris.feature_names)

print("\nNombres de las especies:")
print(iris.target_names)

print("\nTamaño de los datos:")
print(iris.data.shape)
Nombres de las variables:
['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
Nombres de las especies:
['setosa' 'versicolor' 'virginica']
Tamaño de los datos:
(150, 4)
Parte 3: Crear un DataFrame
Un DataFrame es una tabla. Esto hace que los datos sean más fáciles de leer, explorar y explicar a los estudiantes.
df = pd.DataFrame(
    iris.data,
    columns=iris.feature_names
)

df["species_id"] = iris.target
df["species"] = df["species_id"].map({
    0: "setosa",
    1: "versicolor",
    2: "virginica"
})

df.head()Actividad breve
Observa la tabla anterior y responde:
¿Qué representa cada fila?
¿Qué representa cada columna?
¿Cuál columna queremos predecir?
¿Cuáles columnas usaría el modelo para aprender?
Parte 4: Explorar los datos
Antes de entrenar un modelo, debemos conocer los datos. Ejecuta las siguientes celdas.
df.shape(150, 6)df.info()<class 'pandas.DataFrame'>
RangeIndex: 150 entries, 0 to 149
Data columns (total 6 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 sepal length (cm) 150 non-null float64
1 sepal width (cm) 150 non-null float64
2 petal length (cm) 150 non-null float64
3 petal width (cm) 150 non-null float64
4 species_id 150 non-null int64
5 species 150 non-null str
dtypes: float64(4), int64(1), str(1)
memory usage: 7.2 KB
df.describe()df["species"].value_counts()species
setosa 50
versicolor 50
virginica 50
Name: count, dtype: int64Preguntas para discutir
¿Cuántas flores hay en total?
¿Cuántas especies hay?
¿Hay la misma cantidad de flores por especie?
¿Por qué sería importante revisar esto antes de entrenar un modelo?
Parte 5: Visualizar los datos
Las gráficas nos ayudan a ver patrones. Primero miraremos la relación entre longitud del pétalo y ancho del pétalo.
plt.figure(figsize=(8, 5))

for species in df["species"].unique():
    subset = df[df["species"] == species]
    plt.scatter(
        subset["petal length (cm)"],
        subset["petal width (cm)"],
        label=species,
        alpha=0.8
    )

plt.xlabel("Longitud del pétalo (cm)")
plt.ylabel("Ancho del pétalo (cm)")
plt.title("Relación entre longitud y ancho del pétalo")
plt.legend()
plt.show()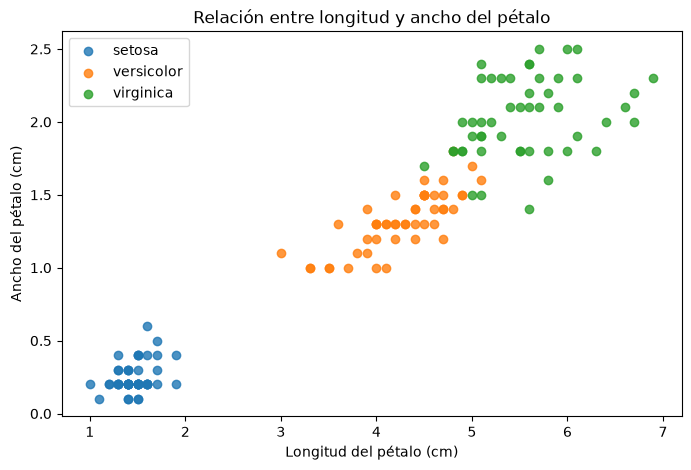
Preguntas para observar la gráfica
¿Ves grupos separados?
¿Cuál especie parece más fácil de distinguir?
¿Cuáles especies parecen más cercanas entre sí?
¿Crees que un modelo podría aprender a separarlas?
Parte 6: Preparar X y y
En Machine Learning supervisado necesitamos separar los datos en dos partes:
X: variables de entrada o características.y: respuesta correcta o variable objetivo.
En este caso, X serán las medidas de las flores y y será la especie de la flor.
X = df[[
    "sepal length (cm)",
    "sepal width (cm)",
    "petal length (cm)",
    "petal width (cm)"
]]

y = df["species"]

print("Primeras filas de X:")
display(X.head())

print("Primeras filas de y:")
display(y.head())
Primeras filas de X:
Primeras filas de y:
0    setosa
1    setosa
2    setosa
3    setosa
4    setosa
Name: species, dtype: strActividad
Explica con tus propias palabras:
¿Qué información contiene
X?¿Qué información contiene
y?¿Por qué no incluimos la columna
speciesdentro deX?
Parte 7: Dividir datos en entrenamiento y prueba
El modelo debe aprender con una parte de los datos y evaluarse con otra parte que no haya visto. Esto nos ayuda a saber si el modelo realmente aprendió patrones generales.
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y
)

print("Datos para entrenar:", X_train.shape)
print("Datos para probar:", X_test.shape)
Datos para entrenar: (112, 4)
Datos para probar: (38, 4)
Preguntas para discutir
¿Qué porcentaje de datos se usó para prueba?
¿Por qué usamos
stratify=y?¿Por qué es importante que el modelo no vea los datos de prueba durante el entrenamiento?
Parte 8: Entrenar el primer modelo
Usaremos Regresión Logística como primer modelo de clasificación. Aunque tiene la palabra “regresión” en el nombre, este modelo se puede usar para clasificar categorías.
model = LogisticRegression(max_iter=1000)

model.fit(X_train, y_train)

print("Modelo entrenado correctamente.")
Modelo entrenado correctamente.
Pregunta clave
¿Qué significa que el modelo fue entrenado?
Escribe una respuesta en tus propias palabras antes de continuar.
Parte 9: Hacer predicciones
Ahora el modelo intentará predecir la especie de las flores del conjunto de prueba.
y_pred = model.predict(X_test)

comparacion = pd.DataFrame({
    "Real": y_test.values,
    "Predicción": y_pred
})

comparacion.head(15)Actividad
Observa la tabla anterior.
¿Cuáles predicciones fueron correctas?
¿Ves algún error?
¿Cómo podríamos contar cuántas predicciones fueron correctas?
Parte 10: Evaluar con accuracy
El accuracy nos dice qué proporción de predicciones fueron correctas.
accuracy = accuracy_score(y_test, y_pred)

print(f"Accuracy del modelo: {accuracy:.2f}")
Accuracy del modelo: 0.95
Interpretación
1.00significa que el modelo acertó todas las predicciones.0.80significa que acertó el 80%.0.50significa que acertó la mitad.
Preguntas
¿El resultado te parece bueno?
¿Crees que accuracy es suficiente para evaluar un modelo?
¿Qué tipo de errores podría estar cometiendo?
Parte 11: Matriz de confusión
La matriz de confusión muestra dónde el modelo acierta y dónde se equivoca. Es una herramienta muy útil porque no solo nos dice cuántos errores hubo, sino también qué clases se confundieron.
ConfusionMatrixDisplay.from_predictions(
    y_test,
    y_pred
)

plt.title("Matriz de confusión - Regresión Logística")
plt.show()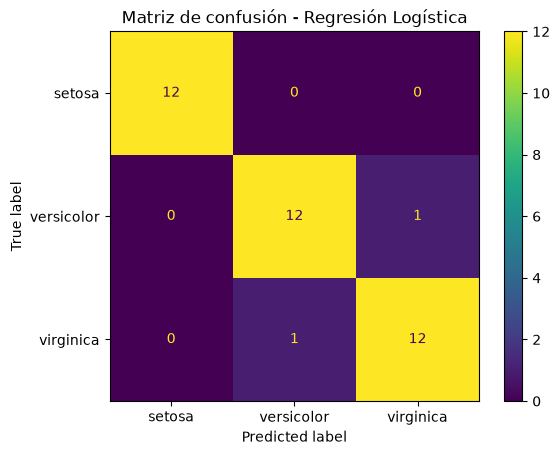
print(classification_report(y_test, y_pred)) precision recall f1-score support
setosa 1.00 1.00 1.00 12
versicolor 0.92 0.92 0.92 13
virginica 0.92 0.92 0.92 13
accuracy 0.95 38
macro avg 0.95 0.95 0.95 38
weighted avg 0.95 0.95 0.95 38
Preguntas para interpretar
¿Qué especie clasificó mejor el modelo?
¿Qué especies confundió más?
¿Por qué algunas especies podrían ser más difíciles de separar?
¿Cómo usarías esta matriz para explicar errores a tus estudiantes?
Parte 12: Probar una flor nueva
Ahora vamos a inventar una flor nueva y pedirle al modelo que prediga su especie. Puedes cambiar los valores para explorar cómo cambia la predicción.
nueva_flor = pd.DataFrame({
    "sepal length (cm)": [5.1],
    "sepal width (cm)": [3.5],
    "petal length (cm)": [1.4],
    "petal width (cm)": [0.2]
})

prediccion = model.predict(nueva_flor)
probabilidades = model.predict_proba(nueva_flor)

print("Predicción del modelo:", prediccion[0])

pd.DataFrame(
    probabilidades,
    columns=model.classes_
)
Predicción del modelo: setosa
Actividad
Cambia los valores de nueva_flor y ejecuta nuevamente la celda.
Prueba:
Una flor con pétalos pequeños.
Una flor con pétalos medianos.
Una flor con pétalos grandes.
Una flor con valores poco comunes.
Luego responde:
¿La predicción cambia?
¿Qué variable parece influir más?
¿El modelo siempre parece seguro?
Parte 13: Retos guiados
Ahora es tu turno de experimentar. La idea es modificar el modelo y comparar resultados.
Reto 1: Usar solo variables del pétalo
Copia y ejecuta la siguiente celda. Luego compara el accuracy con el modelo anterior.
X_petal = df[[
    "petal length (cm)",
    "petal width (cm)"
]]

y = df["species"]

X_train_p, X_test_p, y_train_p, y_test_p = train_test_split(
    X_petal,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y
)

model_petal = LogisticRegression(max_iter=1000)
model_petal.fit(X_train_p, y_train_p)

y_pred_p = model_petal.predict(X_test_p)

accuracy_petal = accuracy_score(y_test_p, y_pred_p)

print(f"Accuracy usando solo pétalos: {accuracy_petal:.2f}")
Accuracy usando solo pétalos: 0.95
Preguntas del Reto 1
¿El modelo mejoró, empeoró o quedó parecido?
¿Qué nos dice esto sobre las variables del pétalo?
¿Crees que todas las variables son igualmente importantes?
Reto 2: Usar solo variables del sépalo
Ahora probaremos con las variables del sépalo.
X_sepal = df[[
    "sepal length (cm)",
    "sepal width (cm)"
]]

y = df["species"]

X_train_s, X_test_s, y_train_s, y_test_s = train_test_split(
    X_sepal,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y
)

model_sepal = LogisticRegression(max_iter=1000)
model_sepal.fit(X_train_s, y_train_s)

y_pred_s = model_sepal.predict(X_test_s)

accuracy_sepal = accuracy_score(y_test_s, y_pred_s)

print(f"Accuracy usando solo sépalos: {accuracy_sepal:.2f}")
Accuracy usando solo sépalos: 0.79
Preguntas del Reto 2
¿Qué conjunto de variables funcionó mejor: pétalos o sépalos?
¿Qué podríamos concluir?
¿Cómo conectarías esto con la idea de seleccionar buenas variables en un proyecto real?
Reto 3: Cambiar el tamaño del conjunto de prueba
Ahora cambiaremos test_size de 0.25 a 0.30.
X_train_30, X_test_30, y_train_30, y_test_30 = train_test_split(
    X,
    y,
    test_size=0.30,
    random_state=42,
    stratify=y
)

model_30 = LogisticRegression(max_iter=1000)
model_30.fit(X_train_30, y_train_30)

y_pred_30 = model_30.predict(X_test_30)

accuracy_30 = accuracy_score(y_test_30, y_pred_30)

print(f"Accuracy con test_size=0.30: {accuracy_30:.2f}")
Accuracy con test_size=0.30: 0.93
Preguntas del Reto 3
¿Cambió el accuracy?
¿Por qué podría cambiar?
¿Qué pasaría si usamos muy pocos datos para entrenar?
¿Qué pasaría si usamos muy pocos datos para probar?
Reto 4: Probar otro modelo
Ahora probaremos un modelo llamado Árbol de Decisión. Este modelo toma decisiones usando preguntas como: ¿la longitud del pétalo es mayor que cierto valor?
tree_model = DecisionTreeClassifier(
    random_state=42,
    max_depth=3
)

tree_model.fit(X_train, y_train)

y_pred_tree = tree_model.predict(X_test)

accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f"Accuracy del Árbol de Decisión: {accuracy_tree:.2f}")
Accuracy del Árbol de Decisión: 0.89
ConfusionMatrixDisplay.from_predictions(
    y_test,
    y_pred_tree
)

plt.title("Matriz de confusión - Árbol de Decisión")
plt.show()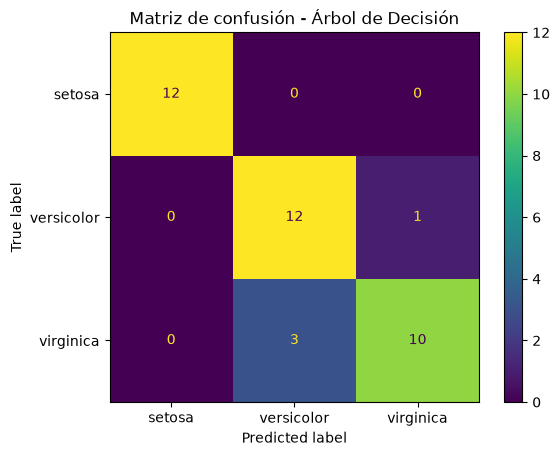
Preguntas del Reto 4
¿Cuál modelo funcionó mejor: Regresión Logística o Árbol de Decisión?
¿El Árbol de Decisión cometió los mismos errores?
¿Por qué sería útil probar más de un modelo?
Parte 14: Reflexión docente
Machine Learning no se trata solo de obtener un número alto de accuracy. También debemos preguntar:
¿De dónde vienen los datos?
¿Qué variables usamos?
¿Qué variables faltan?
¿Qué errores comete el modelo?
¿Qué consecuencias tendría usar este modelo en la vida real?
¿Cómo explicaríamos el resultado a estudiantes?
Actividad de reflexión
Responde individualmente o en grupos:
¿Qué aprendiste sobre clasificación?
¿Qué parte del proceso te pareció más clara?
¿Qué parte te pareció más difícil?
¿Cómo podrías adaptar este proyecto a tu materia?
¿Qué cuidado ético deberías tener si usas datos de estudiantes?
Parte 15: Diseña tu propio proyecto de Machine Learning
Ahora diseña una idea de proyecto para tus estudiantes. Completa la siguiente guía.
Plantilla de proyecto
Materia:
Escribe aquí tu materia.
Grado:
Escribe aquí el nivel de tus estudiantes.
Pregunta del proyecto:
Ejemplo: ¿Podemos clasificar especies de plantas usando medidas simples?
Tipo de problema:
Regresión o clasificación.
Dataset posible:
Describe qué datos usarías.
Variables de entrada X:
Lista las variables que usará el modelo.
Variable objetivo y:
Indica qué quieres predecir.
Modelo inicial:
LogisticRegression, DecisionTreeClassifier u otro.
Métrica de evaluación:
Accuracy, matriz de confusión u otra.
Posibles riesgos o limitaciones:
Describe qué podría salir mal o qué información faltaría.
Conexión con tu clase:
Explica cómo esto ayudaría a tus estudiantes a aprender mejor el tema.
Ideas de proyectos por materia
| Materia | Idea de proyecto |
|---|---|
| Biología | Clasificar especies usando medidas físicas |
| Física | Clasificar movimientos como uniforme o acelerado |
| Química | Clasificar materiales según propiedades |
| Matemáticas | Predecir si un patrón pertenece a una categoría |
| Ciencias ambientales | Clasificar calidad del agua o condiciones climáticas |
| Tecnología | Clasificar mensajes como spam o no spam |
| Educación general | Identificar si una actividad necesita repaso o extensión |
Cierre del proyecto
En este proyecto trabajaste con datos reales, entrenaste un modelo y evaluaste sus resultados.
El flujo completo fue:
Cargar datos.
Explorar datos.
Visualizar patrones.
Separar
Xyy.Dividir entrenamiento y prueba.
Entrenar un modelo.
Hacer predicciones.
Evaluar resultados.
Comparar modelos.
Reflexionar sobre el uso educativo.
Este flujo es la base de muchos proyectos de Machine Learning.
Mensaje final para docentes
No necesitas convertirte en científico de datos para enseñar ideas importantes de Machine Learning.
Puedes comenzar con preguntas sencillas, datasets pequeños y actividades guiadas.
Lo más importante es que tus estudiantes aprendan a:
hacer preguntas con datos
observar patrones
interpretar resultados
reconocer errores
pensar críticamente sobre la tecnología
Machine Learning es una herramienta. El aprendizaje sigue dependiendo de la curiosidad, la reflexión y la guía del maestro.